Indice dei contenuti
Il coding assistito dall’intelligenza artificiale è ormai entrato stabilmente nei flussi di lavoro degli sviluppatori. Il problema è che, nella maggior parte dei casi, questi strumenti funzionano attraverso servizi cloud: ciò significa abbonamenti mensili, limiti di utilizzo e consumo di token.
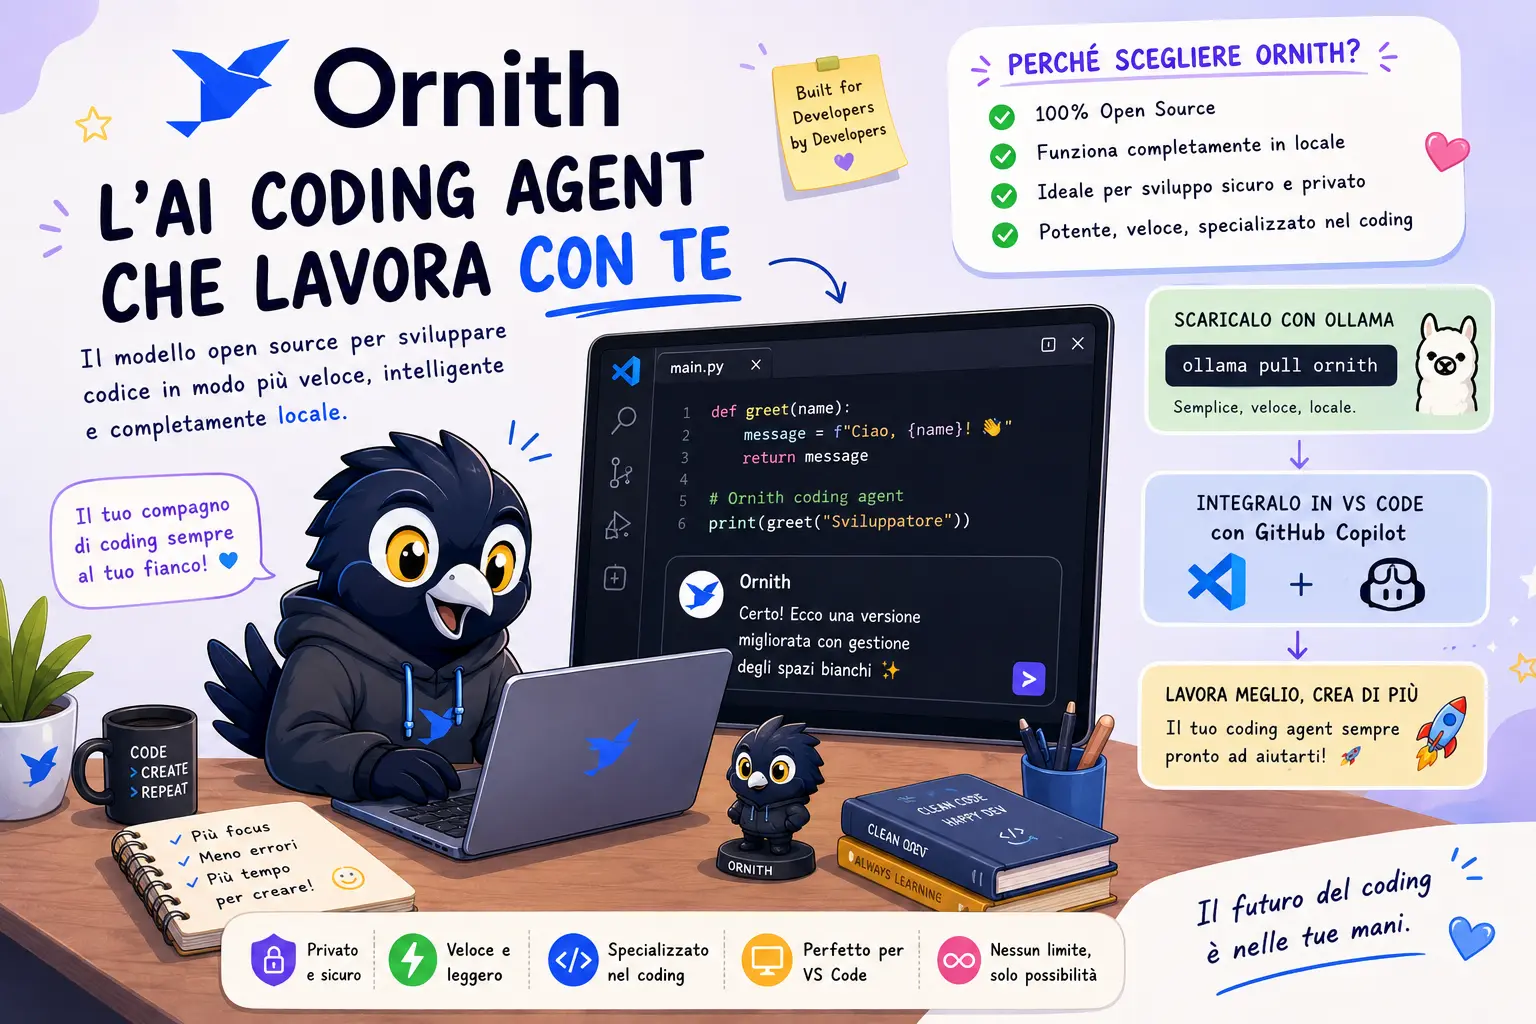
Per questo sto sperimentando sempre più soluzioni locali, eseguite direttamente sulla mia macchina. Tra i modelli che mi stanno dando maggiore soddisfazione c’è Ornith, un modello AI progettato specificamente per il coding agent e pensato per lavorare all’interno del ciclo di sviluppo software.
Il progetto è disponibile sul sito ufficiale ornith.ai e, dopo aver provato il modello quantizzato Ornith 1, mi sto preparando a testare anche la versione più recente, Ornith 1.5 🚀
Perché puntare su un coding agent locale? 🖥️
La motivazione principale è molto concreta: evitare di dipendere completamente dai costi e dai token dei servizi AI in cloud. Gli strumenti cloud sono spesso estremamente veloci e potenti, ma un utilizzo quotidiano e intensivo può comportare:
- abbonamenti ricorrenti;
- limiti mensili o giornalieri;
- consumo di token per ogni richiesta;
- dipendenza dalla connessione Internet;
- necessità di inviare codice e contesto a infrastrutture esterne.
Un modello locale non elimina ogni limite, ma cambia completamente il rapporto con l’AI. Una volta scaricato, può essere eseguito direttamente dal proprio computer e utilizzato senza pagare ogni singola richiesta.
Il vero costo si sposta sull’hardware: RAM, CPU, GPU e spazio su disco diventano i fattori determinanti per ottenere una buona esperienza d’uso.
Ornith: un modello pensato per il coding agent 🤖
Ornith non è un semplice modello conversazionale utilizzato per generare qualche snippet. Il suo interesse principale sta nell’utilizzo come coding agent, cioè come assistente capace di lavorare su un progetto tenendo conto del contesto, dei file e delle richieste operative dello sviluppatore.
In questo scenario, l’AI può aiutare a:
- analizzare file e cartelle del progetto;
- generare nuove funzioni e componenti;
- modificare codice esistente;
- individuare possibili errori;
- proporre refactoring;
- creare test e documentazione;
- spiegare il funzionamento di porzioni di codice;
- supportare attività ripetitive direttamente dall’editor.
Il vantaggio di un modello specializzato per il coding è che il suo comportamento dovrebbe essere orientato maggiormente alla comprensione delle strutture software, delle dipendenze e delle relazioni tra file, invece di limitarsi a produrre risposte generiche.
La versione quantizzata: meno peso, più portabilità 📦
Il modello che sto utilizzando è una versione quantizzata di Ornith 1. La quantizzazione consente di ridurre il consumo di memoria del modello, rendendolo più semplice da eseguire su hardware consumer.
In termini pratici, un modello quantizzato utilizza rappresentazioni numeriche più compatte rispetto alla versione originale. Questo permette di diminuire il peso su disco e il consumo di RAM o VRAM, con un possibile compromesso sulla qualità delle risposte.
Il compromesso, però, può essere assolutamente accettabile quando l’obiettivo è usare l’AI in locale. Un modello leggermente meno preciso ma eseguito direttamente sul proprio computer può risultare più utile, economico e riservato rispetto a un modello più grande accessibile esclusivamente tramite cloud.
Installare Ornith con Ollama è semplice ⚙️
Uno dei motivi per cui sto apprezzando questo tipo di sperimentazione è la semplicità offerta da Ollama. Il runtime permette di scaricare ed eseguire modelli locali tramite comandi molto brevi.
Una volta installato Ollama, il modello può essere scaricato con un comando di questo tipo:
ollama pull ornith:35b-q4_K_M
La sintassi precisa può variare in base al nome pubblicato nel catalogo o nel registry utilizzato, quindi è sempre importante verificare il model tag ufficiale prima di eseguire il comando.
Per verificare i modelli presenti sulla macchina è possibile usare:
ollama ls
Questa modalità rende molto semplice provare versioni differenti, confrontare prestazioni e valutare quale modello sia più adatto al proprio hardware.
Configurare Ollama in rete locale 🌐
Nel mio caso, Ollama viene eseguito sulla macchina principale, mentre l’ambiente di sviluppo può trovarsi su un’altra macchina o all’interno di una macchina virtuale. Per consentire il collegamento è necessario rendere raggiungibile il servizio Ollama nella rete locale.
Per impostazione predefinita, il servizio viene generalmente utilizzato tramite l’endpoint locale:
http://127.0.0.1:11434
Se il client si trova su una VM o su un altro computer, l’indirizzo 127.0.0.1 non sarà sufficiente, perché indicherà la macchina su cui gira il client e non necessariamente l’host che esegue Ollama.
In quel caso bisogna:
- configurare Ollama per ascoltare sull’interfaccia di rete corretta;
- identificare l’indirizzo IP della macchina host;
- verificare che la porta di Ollama sia raggiungibile;
- configurare firewall e regole di rete;
- evitare di esporre il servizio direttamente su Internet senza protezioni.
Il principio è semplice: il client deve puntare all’IP dell’host e alla porta su cui Ollama è in ascolto, ad esempio:
http://192.168.1.100:11434
L’indirizzo è soltanto un esempio: nella configurazione reale bisogna utilizzare l’IP assegnato alla propria macchina.
Usare Ornith con GitHub Copilot in VS Code 🧩
La parte più interessante della configurazione è la possibilità di utilizzare un modello locale all’interno del proprio flusso di lavoro in VS Code. Se l’integrazione supporta un endpoint compatibile con Ollama, è sufficiente indicare:
- l’indirizzo IP della macchina che esegue Ollama;
- la porta del servizio;
- il nome del modello Ornith scaricato;
- eventuali parametri relativi a contesto e comportamento.
In pratica, il flusso diventa:
VS Code

↓

GitHub Copilot o client compatibile

↓

API Ollama

↓

Ornith locale

↓

Risposta o modifica al codice
Una volta configurato correttamente il provider, il modello è immediatamente disponibile per attività come completamento, spiegazione del codice, generazione di funzioni e supporto al refactoring.
Il risultato è interessante perché l’interfaccia di sviluppo rimane familiare, mentre il motore AI gira localmente sulla propria infrastruttura. Non è necessario cambiare completamente metodo di lavoro: cambia il backend che produce le risposte.
Un esempio di configurazione concettuale 🛠️
La configurazione effettiva dipende dal client e dalla versione utilizzata, ma il concetto è generalmente simile a questo:
{

"provider": "ollama",

"model": "ornith:1",

"apiBase": "http://192.168.1.100:11434",

"contextLength": 32768

}
Il parametro apiBase rappresenta l’indirizzo dell’API Ollama raggiungibile dalla macchina di sviluppo. Il parametro relativo alla finestra di contesto, invece, deve essere scelto in base alle capacità effettive del modello e dell’hardware.
Una finestra di contesto più ampia può aiutare nei progetti complessi, ma tende a richiedere più memoria. Per questo non è sempre conveniente impostare il valore massimo disponibile: il valore corretto è quello che garantisce un buon equilibrio tra qualità e velocità.
Le prestazioni dipendono dall’hardware 🎮⚡
Qui emerge il principale limite dell’AI locale: il modello non può superare le capacità della macchina che lo esegue.
Le prestazioni dipendono da diversi componenti:
- GPU: determina spesso la velocità di generazione dei token;
- VRAM: stabilisce quanto del modello può essere caricato direttamente sulla scheda video;
- RAM: diventa importante quando il modello non entra completamente in VRAM;
- CPU: può sostenere l’inferenza quando parte del modello viene eseguita lato processore;
- SSD: influenza tempi di caricamento e gestione dei file;
- raffreddamento: fondamentale durante sessioni prolungate.
Una macchina gaming ben equipaggiata può offrire risultati molto interessanti, ma ogni configurazione è diversa. Lo stesso modello può essere rapido su una workstation con molta VRAM e decisamente più lento su un computer con poca memoria disponibile.
Ornith 1: ottimo per iniziare, con qualche limite 🐣
La mia esperienza con Ornith 1 è positiva. Per attività quotidiane e progetti di dimensioni contenute, il modello riesce a essere un assistente utile, rapido e facilmente integrabile.
È particolarmente interessante per:
- funzioni isolate;
- script di automazione;
- API semplici;
- componenti frontend;
- correzione di errori circoscritti;
- generazione di test di base;
- spiegazione di codice esistente.
Quando però si passa a progetti complessi, con molti file, architetture articolate e dipendenze numerose, emergono alcune difficoltà. Il modello può perdere parte del contesto, proporre modifiche incomplete o non comprendere pienamente le relazioni tra i componenti.
Questo non significa che Ornith non sia valido: significa semplicemente che un modello locale deve essere valutato per quello che è, tenendo conto della quantizzazione, della finestra di contesto e della potenza dell’hardware disponibile.
Ornith 1.5: il prossimo test 🔬
La versione successiva, Ornith 1.5, rappresenta il prossimo passaggio della mia sperimentazione. Sarà interessante verificare se offre miglioramenti in aree come:
- gestione del contesto;
- coerenza tra più file;
- capacità di seguire istruzioni articolate;
- qualità del codice generato;
- correzione degli errori;
- stabilità nei task agentici;
- velocità e consumo di memoria.
Il confronto più utile non sarà soltanto sulla qualità delle risposte, ma anche sul rapporto tra risultato, risorse utilizzate e velocità. Un modello migliore in assoluto non è necessariamente il modello migliore per ogni computer.
Il modello giusto dipende dal progetto 🎯
Uno degli errori più comuni quando si sperimenta l’AI locale è scegliere il modello più grande disponibile pensando che sia automaticamente il migliore. In realtà, il modello ideale dipende da:
- linguaggi utilizzati;
- dimensione del progetto;
- complessità dei task;
- quantizzazione scelta;
- quantità di RAM e VRAM;
- velocità desiderata;
- necessità di esecuzione offline.
Per trovare una configurazione adatta, può essere utile chiedere a un altro sistema AI di analizzare i modelli disponibili nel catalogo ufficiale di Ollama e proporre una scelta basata sulle componenti del proprio PC.
Un prompt utile potrebbe essere:
Analizza i modelli ufficialmente disponibili su Ollama per il coding agent.

Confrontali in base a:

- GPU e VRAM disponibili;

- RAM;

- CPU;

- sistema operativo;

- dimensione dei progetti;

- linguaggi utilizzati;

- necessità di esecuzione locale;

- velocità desiderata.
Suggerisci il modello più adatto e una quantizzazione equilibrata,
motivando chiaramente la scelta.
È importante verificare che l’analisi utilizzi informazioni aggiornate sul catalogo Ollama e che non si basi soltanto sulla popolarità del modello. La valutazione deve tenere conto dell’hardware reale e del tipo di lavoro che si vuole svolgere.
AI locale e sicurezza: vantaggi, ma anche responsabilità 🔐
Utilizzare Ornith in locale offre un maggiore controllo sul codice e sui dati trasmessi, ma non significa che ogni rischio scompaia automaticamente.
È comunque necessario:
- limitare l’accesso all’API Ollama alla rete necessaria;
- configurare correttamente il firewall;
- non esporre la porta pubblicamente senza autenticazione e protezioni;
- prestare attenzione ai permessi degli strumenti agentici;
- verificare ogni modifica proposta dal modello;
- non inserire segreti o credenziali nei prompt;
- eseguire test e controlli di sicurezza sul codice generato.
Un coding agent può leggere file, proporre modifiche e, in alcuni casi, interagire con il terminale. Per questo è opportuno utilizzarlo inizialmente in ambienti isolati, repository di test o macchine virtuali.
Cloud e locale non devono essere nemici ☁️🏠
La scelta non deve necessariamente essere un aut-aut. Il cloud rimane molto utile per:
- progetti complessi;
- analisi di grandi codebase;
- task che richiedono ragionamento avanzato;
- generazione rapida di output molto articolati;
- collaborazione tra più persone.
L’AI locale, invece, può essere preferibile per:
- prototipi;
- esperimenti;
- codice privato;
- automazioni;
- sviluppo offline;
- task ripetitivi;
- riduzione del consumo di token e abbonamenti.
Un approccio ibrido può quindi essere la soluzione più equilibrata: modello locale per le attività quotidiane e servizio cloud solo quando il progetto richiede maggiore capacità di ragionamento o una finestra di contesto più ampia.
La mia valutazione personale 🐦
Ornith 1 mi sta dando una buona impressione perché è semplice da installare, relativamente leggero nella sua versione quantizzata e immediato da integrare con Ollama e VS Code.
Non lo considero ancora una sostituzione universale dei modelli cloud più potenti, soprattutto per progetti complessi. Tuttavia, è un’opzione molto interessante per chi vuole iniziare a costruire un vero workflow di AI locale applicata allo sviluppo.
La parte più importante è proprio questa: non si tratta di cercare il modello perfetto, ma di trovare un equilibrio tra qualità, velocità, consumi, privacy e costi.
Con l’arrivo di Ornith 1.5, sarà interessante capire quanto il progetto sia riuscito a migliorare nella gestione dei task articolati e nell’utilizzo come agente operativo all’interno dell’IDE.
Un piccolo laboratorio AI sulla scrivania 🔧✨
Quello che mi entusiasma di più è la possibilità di trasformare un normale computer personale in un laboratorio AI completamente autonomo. Una macchina da gaming, una VM Linux, Ollama, VS Code e un modello quantizzato possono diventare una piattaforma di sviluppo molto potente.
Non è ancora tutto perfetto, e non deve esserlo. La sperimentazione serve proprio a capire dove questi strumenti funzionano bene, dove mostrano i loro limiti e come integrarli in modo responsabile.
Per chi vuole ridurre costi, token e dipendenza dai servizi cloud, Ornith rappresenta un’altra tessera interessante di un ecosistema che sta crescendo rapidamente.
Il futuro del coding assistito potrebbe non essere soltanto nei grandi data center. Potrebbe essere anche sulla nostra scrivania, dentro il nostro PC, con modelli più compatti, più portabili e finalmente sotto il nostro controllo 🐦💻